TAAC-2026:基于 baseline 的模型改进复盘
这篇文章记录 TAAC-2026 代码在官方 baseline 上做过的主要改动,也把目前分数放在前面,方便之后回看。这里的官方 baseline 指比赛给出的原始 baseline/train 代码;0.8289* 是在官方 baseline 上做第一阶段改进后的分数,不是 baseline 本身的分数。
Performance
| 版本 | 分数 | 说明 |
|---|---|---|
| 官方 baseline | 0.813 |
比赛给出的原始 baseline |
| baseline 改进版 | 0.8289* |
在官方 baseline 上做第一阶段改进后的记录 |
| 当前代码 | 0.830368,约 0.8303* |
截图中的 Best Score |
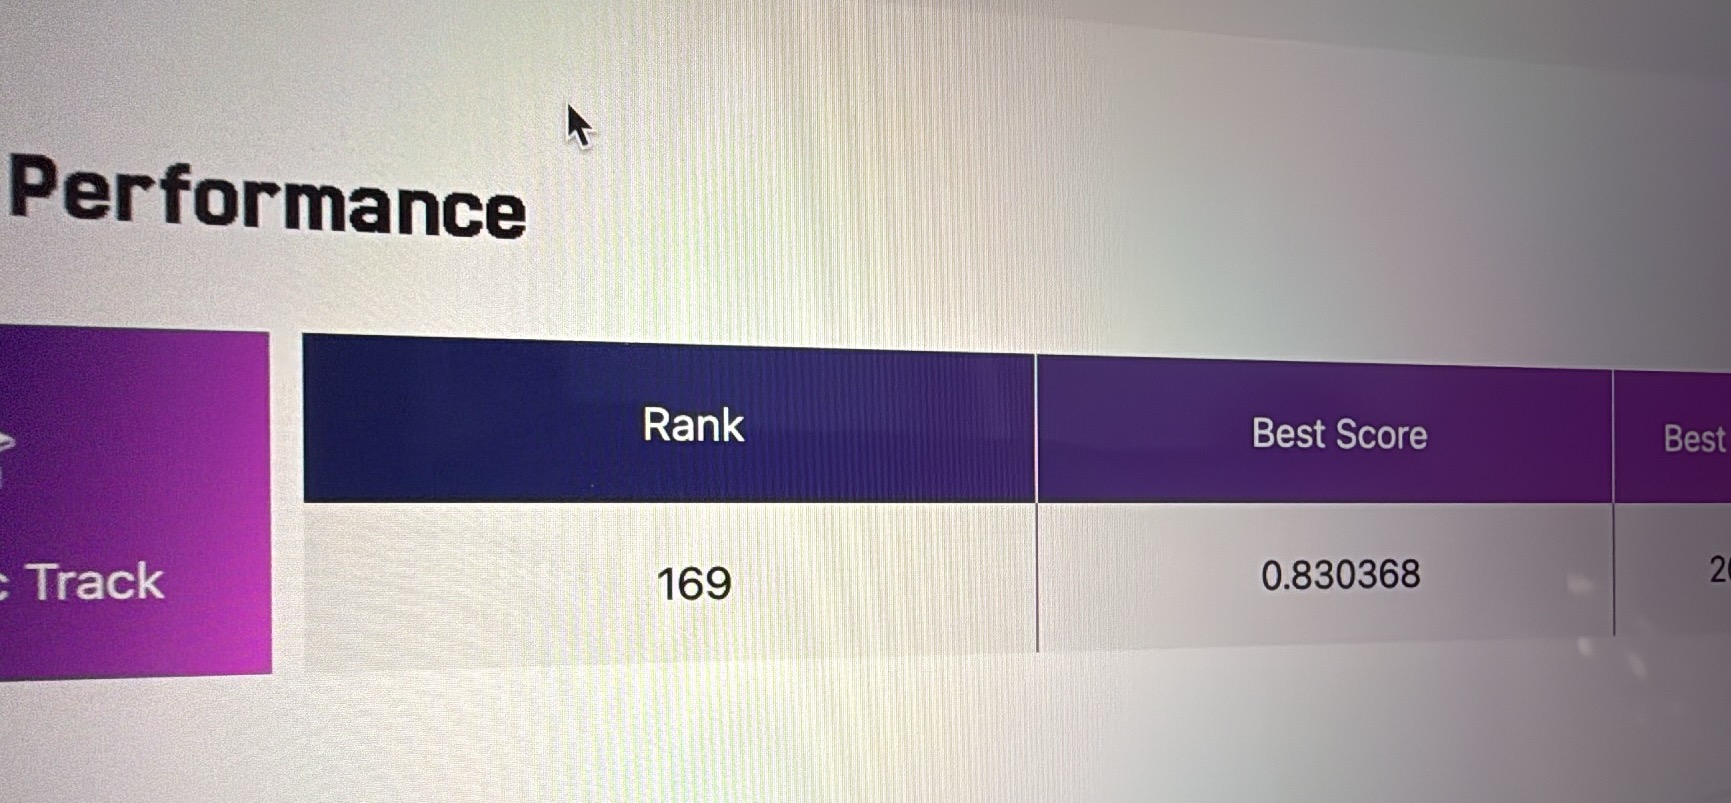
完整代码已经放在 GitHub:zliaaan/TAAC-2026。
为什么改 baseline
baseline 的 HyFormer 主干可以处理多条行为序列,但特征语义还比较粗:
- 用户侧字段里混有 pair 类特征,直接作为普通 user 特征会丢掉
category id + value/score的配对关系。 - 时间信号主要依赖 bucket,序列内部的 recency、间隔、小时、星期和覆盖度没有被充分建模。
- NS token 数量和分组强绑定,表达粒度不够灵活。
- target item 和历史行为之间的匹配不够直接。
- 训练配置依赖运行时参数,checkpoint 到推理环境里容易出现结构不一致。
所以这版代码的重点不是继续堆大模型,而是把用户、商品、序列、时间和训练稳定性拆清楚。
主要改进
pair 特征单独建模
把以下字段从普通 user 特征中拆出来:
PAIR_FEATURES = [62, 63, 64, 65, 66, 89, 90, 91]
数据侧新增 pair_int_schema 和 pair_dense_schema,模型侧新增 CrossRankMixerNSTokenizer。pair int 和 pair dense 按位置对齐建模,再作为 extra embedding 注入 user NS tokenizer。
其中 62-66 的 dense 值做 log1p 压缩,降低长尾计数和异常值影响;89-91 保留相似度或打分型 dense 语义。
高基数字段使用 hash embedding
新增以下参数来处理高基数字段:
--emb_skip_threshold
--hash_bucket_size
--pair_hash_bucket_size
--pair_hash_fields
--pair_hash_bucket_map
当字段超过 embedding 阈值时,可以用固定 bucket 的 HashEmbedding 保留一部分 ID 信号,而不是直接置零。
RankMixer NS tokenizer
当前主线默认使用:
--ns_tokenizer_type rankmixer
--user_ns_tokens 12
--item_ns_tokens 2
RankMixer tokenizer 会先拼接所有 group embedding,经 LHUC gate 做样本级重标定,再切分为可调数量的 NS tokens。这样 user/item NS token 数量不再和 ns_groups.json 强绑定。
user_dense 拆成两个语义 token
user_dense 不再整体过一个 projection,而是拆成:
- 用户 embedding 类 dense token。
- 历史 item embedding 类 dense token。
历史 item embedding 先按 block 切分,再用 learnable attention pooling 聚合有效 block,减少全零用户和弱历史用户对 dense 表征的污染。
时间特征增强
保留原有 time bucket,同时为每个序列位置增加 8 维 float 时间特征:
| 通道 | 含义 |
|---|---|
ch0 |
log1p(diff_days) |
ch1 |
按 domain 定制的时间尺度,seq_c 用月,seq_d 用小时,seq_a/b 用天 |
ch2 |
log1p(diff_hours) |
ch3/ch4 |
hour-of-day 的 cos/sin |
ch5/ch6 |
day-of-week 的 cos/sin |
ch7 |
inter-event gap,按 domain 使用不同尺度 |
每个序列 domain 还增加 6 维统计特征:
log1p(max_diff)log1p(min_diff)log1p(mean_diff)count_<=15mincount_<=1hcount_<=1d
这些统计特征会进入 query generator 和 sequence domain gate。
不做强时间过滤
构造序列时间特征时保留原始 padded slot 对齐关系,不再把事件按 sample_ts 强行 compact/filter,只对负时间差做截断。这样可以避免序列字段和时间字段错位,也避免过滤后破坏原始位置结构。
DIN target-aware 分支
开启 --use_din 后,target item 会对每个序列 domain 的历史 token 做 attention,得到 target-aware history context。最后把 HyFormer output、DIN context 和 item target 一起送入输出 tower。
这个分支不替换 HyFormer 主干,只做输出侧增强。
训练稳定性
训练侧主要加了这些改动:
bce_pairwise:BCEWithLogits + pairwise_lambda * batch_pairwise_losslabel_smoothing=0.01ModelEMA- AdamW + Adagrad 双优化器
- bf16 autocast
- 梯度裁剪
- warmup + cosine decay
- checkpoint 自带
schema.json和train_config.json
其中 checkpoint 自包含比较关键。infer.py 会优先读取 checkpoint 目录里的 train_config.json,再严格构建模型并加载权重,避免训练和推理结构不一致。
版本分支
| 目录 | 定位 |
|---|---|
./ |
主线版本:pair 特征、时间增强、RankMixer、DIN、pairwise loss、EMA |
variant-omega-fusion/ |
融合 CrossNet、SE-Net、NS self-attention、NS output fusion、target-aware attention 和 TIME_MATCH residual |
variant-omega-fusion-focus-ad/ |
在 omega 融合版本上加入 seq_a、seq_d 的 sequence focus gate |
后续消融顺序
我会优先按这个顺序做消融:
- 关闭
--use_din,验证 DIN 输出侧增强是否稳定贡献。 - 调整
pairwise_lambda到0.01/0.05,判断排序辅助项是否过强。 - 关闭 EMA,确认收益来自模型本身还是权重平滑。
- 调整
user_ns_tokens到8/10/12,找 NS token 粒度和参数量平衡。 - 关闭 8 维 float time features,只保留 bucket,验证时间增强是否泛化。
- 对 omega 版本逐个关闭 CrossNet、SE-Net、NS output fusion,排查静态信号重复注入。
- 对 focus-ad 版本关闭
seq_focus_*,验证seq_a/seq_d先验是否真实有效。
后续不建议继续一次性堆很多模块。这个任务里多个模块会表达相似信号,组合后可能出现线下提升但线上不稳。